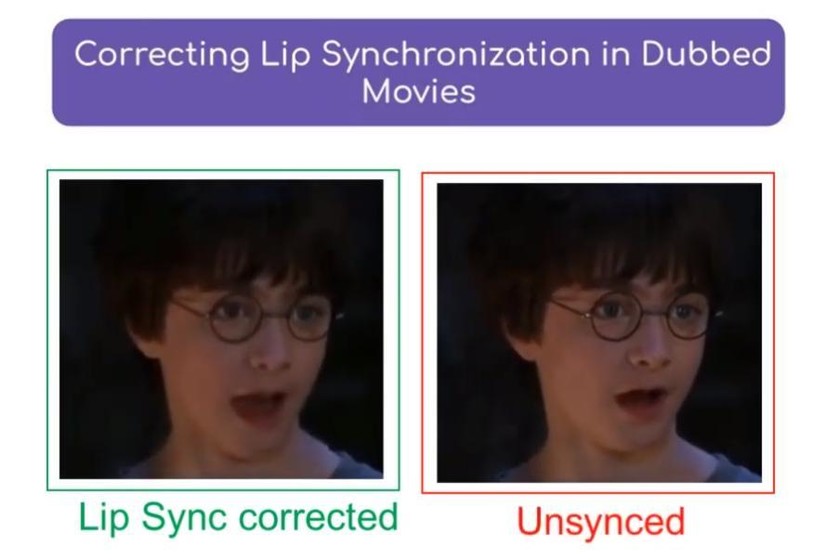
Cercetătorii de la Institutul Internațional de Tehnologia Informației din Hyderabad, India, au dezvoltat un sistem de inteligență artificială capabil să creeze videoclipuri deepfake traduse în diferite limbi. Nu vorbim doar de „audio”, adică subiectul vorbește mai întâi engleză și apoi vorbește în spaniolă, dar software-ul folosește inteligența artificială pentru a emula mișcarea buzelor pentru a PDF) și, potrivit lui Prajwal Renukanand, principalul autor al studiului, comunicarea digitală „devine astăzi din ce în ce mai mult vizuală, „devine în prezent în creștere. este nevoie de sisteme care să poată traduce automat un videoclip al unei persoane care vorbește în limba A în limba B cu sincronizare realistă a buzelor.” Să vedem cum funcționează.
Text, voce și buze
Pentru a-și dezvolta modelul, cercetătorii au creat un sistem de traducere de la vorbire la vorbire prin reunirea diferitelor module de vorbire și limbaj existente. Mai târziu, au implementat LipGAN pentru a face „traducere față în față”. LipGAN, așa cum aproape puteți ghici din numele său, este un sistem de generare a fețelor realiste din sunet care „vorbesc” respectivul sunet cu buzele sincronizate.
Sistemul este împărțit în două subsisteme: traducere de la vorbire la vorbire și sinteza buzelor. Primul combină tehnologii precum ASR (recunoaștere automată a vorbirii), NMT (traducere automată neuronală) și TTS (Text-to-Speech) pentru, mai întâi, a înțelege ce spune audio original; în al doilea rând, traduceți-l într-o altă limbă și în al treilea rând, „vorbiți” în limba țintă folosind vocea subiectului. Pentru a traduce limba engleză, a fost folosit DeepSpeech și pentru a instrui sistemul NMT în limbi indiene, a fost folosită baza de cod de la Facebook AI Research.
 Rezumatul modelului de traducere din vorbire în vorbire.
Al doilea subsistem este sinteza feței subiectului. Pentru aceasta, a fost dezvoltat LipGAN, un model care poate genera fețe vorbitoare ale oricărei persoane din orice fragment audio. Modelul constă din două codificatoare: un codificator facial și un codificator de vorbire. Primul este folosit pentru a „coda informații despre identitatea subiectului”, după cum explică autorii, în timp ce cel din urmă „preia fragmente de vorbire foarte mici (350 ms de audio per fragment) și le folosește pentru a codifica informațiile audio”. În cele din urmă, ieșirea acestor două codificatoare este introdusă într-un decodor care generează o imagine facială sincronizată pe buze cu fragmentul audio.
 Schema modului în care funcționează LipGAN.
Practic, LipGAN este o rețea adversa generativă. Generatorul creează o imagine facială condiționată de intrarea audio, iar discriminatorul verifică dacă cadrele generate și sunetul sunt sincronizate în cel mai bun mod posibil. Pentru a realiza acest lucru, pe lângă imaginile sintetizate, modelul a fost alimentat cu alte mostre sincronizate și nesincronizate pentru a învăța să detecteze cea mai bună sincronizare a buzelor, pe lângă calitatea optimă a imaginii.
În cele din urmă, sistemul a fost supus la două evaluări. În metoda cantitativă au fost utilizate metodele PSNR (Raportul maxim semnal/zgomot), SSIM (Indice de similaritate structurală) și
Conform cercetătorilor, și deși software-ul nu este suficient de rapid pentru a face această traducere în timp real, LipGAN are potențial pentru dublarea de filme, videoclipuri educaționale și pentru interviuri și știri la televizor. „De exemplu, un spectator hindi sau german ar putea viziona un interviu lui Obama în limba lor, cu propria voce și sincronizat cu buzele”, spun autorii studiului.
Nu este prima dată când deepfake-urile sunt puse pe masă ca alternativă pentru animația în filme. Unul dintre cele mai recente exemple este „Gémini”, un film în care Will Smith se confruntă cu o copie digitală a tânărului însuși de 30 de ani. Se estimat că crearea acestui tânăr Will Smith a costat între jumătate de milion și un milion de dolari, plus 100.000 de dolari pentru fiecare scenă, deși Financial Times estimează că costul total al acestei „duble virtuale” a fost de 25 de milioane USD.
Cu o GAN (rețea generativă adversativă) bine pregătită, costul acestui tip de activ ar fi redus drastic. La asta se referă Peter Rojas, de la Betaworks Ventures, prin „democratizarea efectelor speciale”. Darren Hendler, de la VFX House, crede că ceea ce s-a văzut în „Gemeni” și „The Irishman” vor fi ultimele modele 100% digitale de oameni care nu folosesc un anumit tip de GAN, ceea ce duce la o a doua predicție. „Vom începe să vedem astfel de lucruri în producțiile cu buget mai mic.”
Via | NewScientist